-
メール
510711593@qq.com
-
電話
17773134316
-
住所
長沙市長沙大道至雅ビル2301
製品分類
Hunan Baizhong Biotechnology Co., Ltd
Tラビリンスビデオ解析システム
ネゴシエーション可能更新01/22
- モデル
- メーカーの性質
- 生産者
- 製品カテゴリ#セイヒンカテゴリ#(product category)#(product)#(product)#(product)(product)(product)(prod
- 原産地
概要
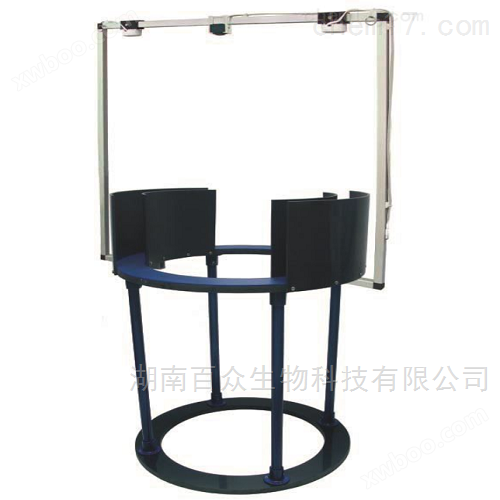
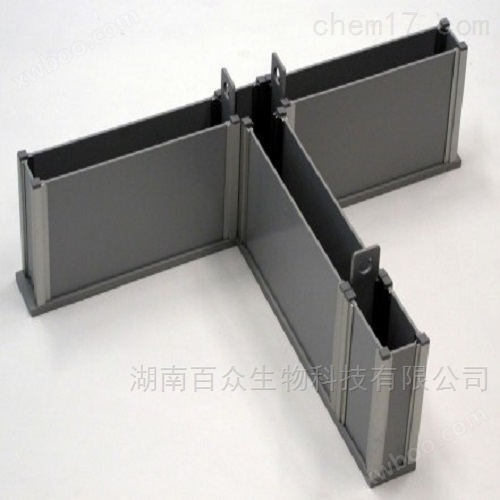
T迷宮ビデオ解析システムは空間学習、条件認識学習、作業記憶の研究に広く用いられている上等な器具である。そのモジュール化された設計により、上海欣軟が開発したT迷路は異なる配置で動作することができる。各システムは2つの選択アームと*領域の上に1つの開始アームから構成されており、各アームには粒子状食品を収容するための食品タンクを配置することができます。Tラビリンスの真上に監視カメラシステムを設置し、Xmaze行動解析ソフトウェアを通じて動物の軌跡データを自動的に追跡記録する。
製品詳細
Tラビリンスビデオ解析システム
一、製品紹介
Tラビリンスビデオ解析システム空間学習、条件認識学習、作業記憶の研究に広く使われている上等な器具です。そのモジュール化された設計により、上海欣軟が開発したT迷路は異なる配置で動作することができる。各システムは2つの選択アームと*領域の上に1つの開始アームから構成されており、各アームには粒子状食品を収容するための食品タンクを配置することができます。Tラビリンスの真上に監視カメラシステムを設置し、Xmaze行動解析ソフトウェアを通じて動物の軌跡データを自動的に追跡記録する。
二、製品の特徴
1.T迷路は工業化設計を採用し、分解洗浄が便利で、アルコールで味を消すことができる。
2.ソフトウェアは動物の軌跡をリアルタイムで追跡し、実験データを計算し、指標がそろっている、
3.伝統的なT迷路実験、及びT迷路自主交替実験を展開することができる、
4.輸入ビデオ分析ソフトウェアとシームレスに接続できる、例えばANY-mazeビデオ解析ソフトウェア
5.ソフトウェアデータの形式は多様であり、excelテーブルに導き出すことができ、ピクチャ形式で保存することもでき、さらにヒストグラム、分散などの*最終処理データの結果出力をサポートすることもできる、
三、製品の材質
迷宮宮体:特製医療用有機板、灰色
撮像スタンド:工業用アルミニウム形材、30*30型番
撮像システム:Xmaze挙動監視銃式カメラ、型番はXR-VD 1
解像度:420ライン\\ 480ライン
収集カード:天敏uv 200、BS 7200
四、実験方法
A.伝統的なT形迷路実験
(1)T形迷路アーム内に6粒の食丸(45 g)を散布することに適応し、ラットを迷路に5 min適応させ、毎日1回、5日間連続する。
(2)強制選択訓練ラットを主幹アームのスタートボックスに入れ、手動でゲートを開き、ラットを迷路の主幹アームに入れる。ランダムに、交互に左右の両腕の1つを選択して4粒の食丸に入れ、同時にもう1つの腕を閉じて、動物が食べ物を選択して腕を強化し、摂食を完了させなければならない。1日6回、4日連続。
(3)遅延位置マッチング(DMP)訓練
a)動物を水門の閉まったスタートボックスに入れ、水門を開けて、動物を主幹アームに入れる。
b)一方の標的アームを閉じ、動物を他方の開放アームに強制的に入れて2粒の食丸賞を得る。
c)直ちに(*短遅延、5 s未満)動物をバックボーンアームに戻し、マッチング訓練中の2回目の訓練を開始する、このとき、両方のターゲットアームが開放されます。動物は、2つの前肢及び少なくとも2つの後肢の一部を1つの目標アームに配置したときに「1回の選択」を完了する。動物が強制選択訓練に戻った時に入った腕に戻ったら、食品賞(4粒の食丸)を受賞し、正しい選択を記録した。動物が別の腕に入ると、餌の報酬はなく、その腕の中に10秒間閉じ込められ、誤った選択が記録される。
(4)1回のマッチング訓練が終了した後、動物をケージ内に5〜10 min戻し(同時に他の動物を訓練する)、次のマッチング訓練を繰り返す。1日8回。
動物の2日間連続の正しい選択回数が15/16に達すると、基準に達したと考えられ、実験を開始することができる。動物が30日間の訓練を経ても基準に達していない場合は、淘汰される。
(5)動物訓練が目標を達成した後の日に、マッチング訓練を与える。異なるのは、強制選択訓練後、T形迷路を180度回転させてから、上記オープンアームの訓練を行うことである。このようにする目的は、動物が定位性操作(迷路外信号に依存)であるか、または反応性操作(迷路外信号に依存しない)であるかどうかを評価することである。
(6)2日間続いて、動物の作業記憶操作を評価するために、1日10回のマッチング訓練を与え、各訓練間隔は60 sであった。食物強化アームに入った回数と非強化アームに再び入った回数を記録する。後者は仕事の記憶違いとされている。正常で健康な若いラットはほぼ毎回正確に操作できる。操作が安定しており、選択精度が高い(作業記憶ミスが10%未満)場合、**テストまたは脳領域破壊後の操作実験を行うことができる。